【系列:人工智能生成与语音保护】第一部分
在一个“声音”拥有自己生命力的时代——为什么“保护声音”在当下如此重要?
“我最喜欢的配音演员正在演唱一首他从未唱过的歌”,“有个视频用某人的声音说了一些他现实生活中绝对不会说的话”——近年来,很多人可能都在社交媒体上看到过这类内容。得益于语音生成人工智能技术的进步,我们已经进入了一个任何人都能轻松创造出与特定人物声音极其相似的声音的时代。
随后,在2026年,这个问题迎来了一个重大转折点。一位知名声优对平台运营商提起的诉讼曝光,司法部成立了“未经授权使用肖像、声音等的民事责任性质研究小组”展开讨论,并于7月28日……《总结报告(草稿)》我们已将此事公之于众。目前,我们正在制定“保护发声者”的规则。
在本系列文章中,我们将循序渐进地阐述国内外围绕语音生成人工智能和“语音保护”的法律、商业和技术发展动态,即使是没有任何法律知识的人也能轻松理解。本系列文章将分几期发布,但读完之后,您将对围绕语音生成人工智能和“语音保护”的讨论有一个清晰的了解,并能轻松追踪未来的新闻和讨论——这正是我们希望打造的系列文章。
该系列的内容未来可能会有所改变,但总体而言,我们计划按以下顺序发布。
- 第一部分:一个“声音”拥有自己生命的时代——为什么“保护声音”在今天如此重要?
- 第二部分:按时间顺序追踪国内外发展动态——从私营部门自卫到规则制定
- 第三部分:究竟什么是“发言权”?——绘制法律保护的全面地图。
- 第四部分:国内版 ①《防止不正当竞争法》能否保护我们的声音?
- 第五期,国内版②:宣传权能否保护声音?
- 第六部分:国内版③ “不被滥用言论的权利”是否存在?
- 第七部分:国内问题 ④ 著作权法、商标法及其他法律
- 第8集:海外篇 ① 美国
- 第九期:海外版② 中国
- 第十集:海外篇 ③ 韩国
- 第11集:海外版④欧盟
- 第十二期:在“保护发声者”方面,接下来会发生什么?
在第一部分中,我们将提供一个介绍,概述目前正在发生的事情。
触发条件是“AI掩护”
讨论的一个常见切入点是所谓“AI翻唱”的泛滥。AI翻唱是指利用人工智能技术(例如语音合成和深度学习)来模仿真实歌手或配音演员的声音,让他们演唱他人的歌曲或朗诵名句。自2023年左右以来,许多未经原作者或其他版权所有者许可而制作的AI翻唱作品开始在视频网站和社交媒体上流传。如今,大量短视频使用与知名配音演员声音极为相似的旁白,还有一些服务允许用户用特定角色的声音进行配音。
我认为造成这种情况的原因主要有三个:(1)材料的可用性,(2)技术,以及(3)衍生作品和用户生成内容(UGC)的基础。
第一个原因是丰富的素材。一般来说,开发语音生成人工智能需要音频源数据,而日本拥有大量优秀的音频作品可供参考。此外,游戏、广播、流媒体和社交媒体等渠道也存在着大量的数字音频数据。对于任何考虑开发语音生成人工智能的人来说(暂且不谈法律问题),毫无疑问,这些都是质量极高的数据。
第二个原因是技术门槛的降低。如今,据说你无需录制成千上万个新词;只需3到10秒的现有音频,就能创建简单的变声器或声音克隆器。此外,世界各地都有各种各样的模型和工具可供公开使用,有些甚至以服务的形式向公众开放。只要掌握一定的知识,你就能使用这些工具,而且我们生活在一个甚至可以“咨询人工智能”如何使用或创建它们的时代。
第三个原因是同人创作的既有基础。“如果我最喜欢的歌手翻唱我最喜欢的歌会怎么样?”这种想法,我想每个粉丝都至少有过一次。如今,技术上已经可以实现,而日本又有着成熟的同人创作文化,并且人工智能翻唱最初也是在同人创作的语境下被接受的,这些因素很可能是人工智能翻唱得以传播的主要推动力。
因此,由于各种因素相互关联,近年来利用“声音”本身的障碍已经显著减少。
这和MAD的视频有什么区别?
提到配音,有些人可能会想到MAD视频。MAD视频是一个统称,指的是将现有动画、游戏、电影等素材剪辑拼接,配上音乐重新剪辑而成的衍生视频作品。例如,MAD视频有很多种类型,有的会幽默地剪辑拼接角色台词,有的则会剪辑拼接动画场景,创造出与原作截然不同的故事。
然而,MAD视频和AI生成的音频之间存在着关键区别。MAD视频中使用的音频通常是表演者本人的声音和表演。相比之下,AI生成的音频是新生成的音源,代表的是表演者从未实际发出过的声音和表演。
此外,许多人工智能生成器生成的声音逼真到足以让听众误以为是本人的真实表演或发言。换句话说,人工智能生成器生成的声音可能在未经本人知情或同意的情况下被当作本人的真实表演或发言。如果未经本人许可就创建和使用语音生成人工智能,可能会对其身份认同造成重大影响。自2023年以来,这种危机感在配音演员和其他声音所有者中日益加剧。
我们遭受了什么?——损害的类型和结构
我本人参与了创作,但配音演员都是志愿者。2026年5月提交给司法部研究小组的文件总体而言,可见的损坏可分为以下五种类型:
- “AI翻唱”是一种利用特定配音演员的声音来演唱其他歌手歌曲的技术。
- 一种可以朗读文本或故事的设备。
- 它允许角色说出他们从未真正说过的话或进行对话。
- 这是一个人工智能生成的视频,它将角色的声音与他们的影像画面结合起来进行重现。
- 这包括出售和发布能够模仿特定配音演员声音的人工智能模型。
如果我们按照流程重新排列,我们可以看到损害是在以下三个阶段发生的。
(a)从动漫和游戏作品中提取配音演员的声音,并将其用作人工智能的训练材料。“学习资料利用”阶段
(i)专门针对特定声音的模型和服务被出售或公开,无论是收费还是免费。“预训练模型的分发和销售等”阶段
(ii)使用该模型生成的语音正在TikTok和YouTube等各种平台上大量发布。“音频生成内容的传播与发布”阶段
围绕语音人工智能和语音保护的辩论的核心问题之一是,语音所有者在每个阶段可以主张什么。
语音人工智能是“坏人”吗?——了解它的优势和劣势
读完这篇文章,有些人可能会觉得人工智能语音是“坏人”。然而,我想强调的是,我并非反对人工智能语音技术本身。前面提到的志愿者配音演员的文件明确指出,他们“并不想反对人工智能语音本身”,而且也有一些配音演员将人工智能语音服务作为正式服务提供。
例如,语音人工智能的优势如下:
① 减少演戏以外的工作量。
② 扩展到原本不可能的事物
③ 声音的保存和传播
④ 开发新的收入来源
以上是一些被提出的观点。
从效率角度来看,减少单调的阅读任务,以及在紧急情况下无需寻找替代者,在某种程度上都是优势。此外,能够在不损害其形象的前提下,将日语字符的语音以当地语言传递给世界各国,并有机会利用语音创造新的收入来源,从拓展的角度来看,这些都是优势。
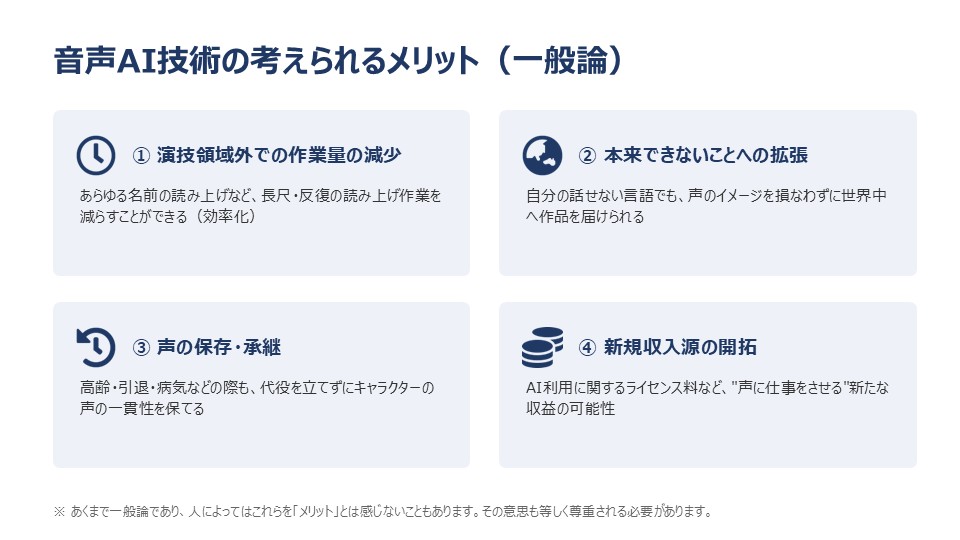
然而,值得注意的是,有些人可能根本不认为这些是有益的。
例如,一些配音演员在遇到无法预见的突发情况而无法继续为某个角色配音时,更倾向于将角色的声音传承给继任者,而不是使用人工智能生成的声音来维持角色的声音,从而促进新一代配音演员的成长。另一些配音演员则担心,使用人工智能生成的声音制作本地化版本,反而会剥夺本地配音演员为自己的作品配音的机会。因此,即使人工智能生成的声音有其优势,这些优势也并非普遍适用,难以概括。
难以概括的缺点也同样适用于语音生成人工智能。下表总结了一些常见的语音生成人工智能缺点:
① 将不属于你的事物误认为“你”的危险。
② 新员工的晋升机会减少等。
③ 就业机会减少
④ 人工智能成为人工智能替代领域的主导力量的影响
⑤ 存在被犯罪利用的风险
等已被指出。
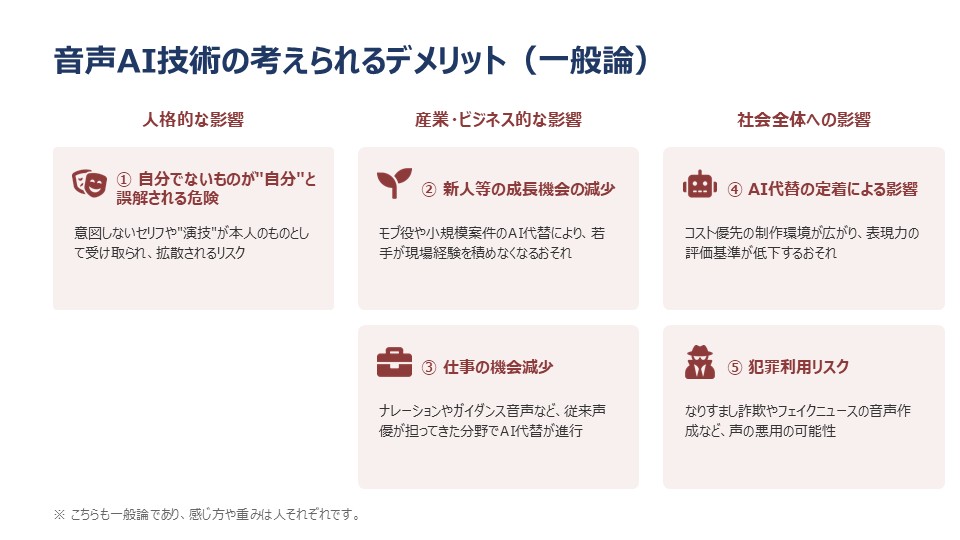
别人用别人的声音把你的声音误认为是你的声音,这种风险会严重影响一个人的身份认同和职业信念。当未经本人许可,用语音生成器制作的声音被广泛传播,而本人却毫不知情时,这种风险尤为明显。对于专业演员来说,被误认为是自己精心创作的表演,无疑是极其痛苦的;同样难以忍受的是,自己无意间说出的话,却被误解为是自己说的。
其他一些相对容易理解的缺点包括:新人发展机会减少、就业机会减少,以及人工智能替代技术的广泛应用带来的影响,所有这些都与配音行业的持续发展息息相关。迄今为止,小型项目、背景角色以及所谓的“背景配音”对于年轻配音演员了解行业和与资深配音演员交流至关重要。如果未来这些工作越来越多地被人工智能生成的声音所取代,一些配音演员担心发展机会将会减少,配音行业也会萎缩。事实上,人工智能语音已经在一些小型旁白项目中得到应用。
2026年,“试验”和“政府考量”开始推进。
认识到这些不同的优势和劣势之后,配音演员们“不再允许未经授权的人工智能生成”基于这些问题以及其他问题,我们一直对未经语音所有者许可而创建的 AI 模型、服务和 AI 生成的声音表示担忧。
我将在下一期(第二部分)中介绍迄今为止的国内发展情况,但随着我们进入 2026 年,有关保护言论自由的情况已经进入了一个新阶段。
首先,在2026年5月,声优津田健次郎向东京地方法院提起诉讼,控告TikTok运营公司未经其许可,使用人工智能生成技术模仿其声音进行旁白的视频。诉状称,涉事账号自2024年7月起至少发布了188个视频,这些视频均以模仿津田的声音进行旁白,内容涉及都市传说和冷知识,每月收入在50万至75万日元之间,具体金额取决于观看次数。2025年8月,法院下令公开发布者的信息,但未能找到发布者,导致津田健次郎于同年11月对TikTok运营公司提起诉讼。
据信这是日本首例未经授权使用人工智能生成的声音的诉讼,指控包括违反《不正当竞争预防法》和侵犯形象权。据报道,运营公司辩称该声音是“独特的男性声音”,但这场备受瞩目的审判涉及诸多关键点,包括该声音是否与人工智能生成的声音“相似”(然而,涉案视频已被删除,因此判决结果如何仍有待观察)。
此外,2026年4月,司法部成立了由专家组成的“未经授权使用肖像、声音等的民事责任性质研究小组”,并于4月24日召开了第一次会议。迄今为止,该小组已举行了五次讨论,旨在根据现行法律和判例,明确在何种情况下可以就未经授权使用人工智能生成的肖像和声音的行为追究民事责任(损害赔偿和禁令)。而7月28日,正如开头提到的……《总结报告(草稿)》报告已发布,最终版本预计很快完成。我计划在“国内篇(二):宣传权能否保护发声者?”中更详细地讨论这份报告的概要。
总之
语音保护问题经常被讨论,尤其是在生成式人工智能的背景下,但语音人工智能技术本身并非“邪恶”。问题在于,专门针对个人声音定制的语音人工智能模型和服务是在未经本人许可的情况下创建的,或者被传播的是非常相似的声音。针对这种情况可以提出哪些法律论据,这正是“语音保护”的核心问题。
近年来,保护配音演员权益的问题日益受到关注,新闻报道也屡见不鲜。然而,直到各个组织和志愿配音演员采取行动,这个问题才真正引起如此广泛的重视。
下次,我想按时间顺序追溯日本国内外的发展历程。
简介
田边幸太郎(三村小松律师事务所律师)
在一家处理包括诉讼、谈判、公司法和知识产权法在内的各种法律事务的公司工作之后,我现在为知识产权法提供全面的支持,包括版权、专利和商标,涵盖从国内和国际合同和系统开发到诉讼的方方面面。
该公司专注于角色相关业务,特别是动漫、漫画、游戏和人工智能领域,致力于为从事角色相关业务的企业和个人提供一站式支持。在语音生成人工智能和语音相关问题方面,该公司积极与配音演员、配音机构、语音人工智能提供商和行业协会保持对话,努力建立语音保护机制。
他曾担任内阁府知识产权战略推进室的兼职助理顾问,参与编写了《人工智能时代知识产权研究小组中期报告》,该报告将“语音保护”作为一个独立议题进行探讨。此外,他还担任日本语音人工智能学习数据认证服务机构的审计员。
我们公司提供关于人工智能生成语音和“语音保护”相关问题的全面咨询服务,从明确权利到考虑具体的应对策略。
点击此处了解一次性咨询和长期合作协议的相关信息。
[2026.7.31]
单击此处获取法律建议和媒体露面
联系我们MiKoTama 电子邮件杂志
通过电子邮件通讯分发各种法律信息主题
田边幸太郎的其他文章
相关文章
-
【系列:人工智能生成与语音保护】第二部分
按时间顺序追踪国内外事态发展——从私人自卫到规则制定“我最喜欢的配音演员正在演唱一首他从未唱过的歌。” “用那个人的声音,他说出了他自己永远不会说的话……”
-
【系列:从业人员商业秘密入门】第四部分(完)
侵犯商业秘密会怎么样?
刑事处罚、民事责任和纪律处分在情节严重的情况下,可能会受到刑事处罚。在严重侵犯商业秘密的情况下,可能会受到刑事处罚。对于个人……
-
【系列:商业专业人士的商业秘密入门】第三部分
最大的争议点:“保密管理”
我们需要的不是“坚不可摧的防御”,而是“可识别性”。为什么“保密管理”会成为争议焦点?商业秘密是无形的“信息”。以专利为例,……